タイトルでわかるとおり、ネタ回です。
はじめに
スーパーは好きですか。僕は好きです。
コンビニは割高なので、原則スーパーでしか買い物をしません。
また、超アルバイターとして約4年ほど働き、精肉、鮮魚、青果と渡り歩いてきました。
ポケモンは好きですか。僕は好きです。
11月19日発売のダイパリメイクに向け、旅パを考えるくらいには発売を楽しみにしています(パール購入予定)。
旅パは固まりつつも、旅をしていく上で、もう一つ重要な要素があります。
そうです。ニックネームです。
ニックネームをつけなければ愛着というものが欠如してしまいます。
つまり、旅パのポケモンたちを超ポケモンにするためにも、ポケモンたちに超な、名前をつけなければなりません。
今回は、僕が超アルバイターとして最後の一年半働いていた青果をテーマに、ポケモンたちのニックネームを決めていきたいと思います。
タスク
超意味分かんないと思うので、何するのかを具体的に説明します。
ポケモンのニックネームを青果にある商品(野菜、果物、花等)から決めます。
青果にある商品の画像を適当に集め、分類器を作成します。その分類器からポケモンの画像がどの青果にある商品に分類されるかで、ニックネームもとを決めます。
そんなん草ポケモンしか意味ないやん。そんな声が聞こえます。僕もそう思います。
※ちなみに御三家はポッチャマで決定なのですが、ニックネームは【すだち】で決定しております。
異論は認めません!
既存の全ポケモンの画像がありますが、ナエトル~アルセウスまでのシンオウ地方だけに抽出します。
Pokemon Images Datasetwww.kaggle.com
花
花はもう少し種類が欲しかったですが、仕方ないですね……。
Flowers Recognitionwww.kaggle.com
野菜と果物
種類が多いので、どんな野菜や果物があるかは、リンク先を参照してください。
また、このデータセットに関してはいくつか変更点があります。
データセットが怪しい
例えばAppleの中にりんごの画像ではなく、某社のロゴや商品があったりしました。
データセットの枚数が不十分
このデータセットの種類が一番多いのですが、100枚ずつと見せかけて、100枚足りないものがありました。
これらはどちらも、自分でダウンロードした別の画像を加えています。
なお、今回の画像データセットに【すだち】はないです。
Fruit and Vegetable Image Recognitionwww.kaggle.com
プログラム
関数定義します。気合と根性のsplitは察してください。
import os
import pickle
import glob as gb
import pandas as pd
import numpy as np
import cv2
import matplotlib.pyplot as plt
import re
from tensorflow.keras.preprocessing.image import ImageDataGenerator, load_img, save_img, img_to_array, array_to_img
def extract_sinnoh(pokemon_path_list):
"""
387~493
ナエトル~アルセウス
"""
sinnoh_pokemon_path_list = []
for pokemon in pokemon_path_list:
number = int(re.sub(r'[f]', '', (pokemon.split('\\')[1].split('.')[0].split('-')[0])))
if number >= 387 and number <= 493:
sinnoh_pokemon_path_list.append(pokemon)
return np.array(sinnoh_pokemon_path_list)
def load_images(image_path_list, pokemon=False, show=False):
npy_image_list = []
for i, image in enumerate(image_path_list):
image_path = image.replace(chr(92), '/')
if i % 100 == 0:
print(i)
img = load_img(image_path, grayscale=False, color_mode='rgb', target_size=(128,128))
img_npy = img_to_array(img)
if pokemon:
index = np.where(img_npy[:, :, 2] == 0)
img_npy[index] = [255, 255, 255]
img_npy = img_npy / 255
if show:
print(img_npy.shape)
plt.imshow(img_npy)
plt.show()
break
npy_image_list.append(img_npy)
return np.array(npy_image_list)
def save_npy_image(save_path, images):
np.save(save_path, images)
print('save ', save_path)
シンオウ地方だけのポケモンを抽出しnpy形式で保存。
npy形式で保存し直しているのは、学習するのに大量の画像を読み込むとメモリ不足で死ぬからです。
pokemon_path_list = gb.glob('D:/OpenData/pokemon_dataset/Pokemon-Images-Dataset/pokemon/*')
sinnoh_pokemon_path_list = extract_sinnoh(pokemon_path_list)
pokemon_image_list = load_images(sinnoh_pokemon_path_list, pokemon=True, show=False)
save_npy_image('D:/OpenData/pokemon_dataset/Pokemon-Images-Dataset/npy/pokemon_sinnoh_128.npy', pokemon_image_list)
花の画像5種類を読み込みnpy形式で保存。
daisy_path_list = gb.glob('D:/OpenData/flowers/raw/daisy/*')
dandelion_path_list = gb.glob('D:/OpenData/flowers/raw/dandelion/*')
rose_path_list = gb.glob('D:/OpenData/flowers/raw/rose/*')
sunflower_path_list = gb.glob('D:/OpenData/flowers/raw/sunflower/*')
tulip_path_list = gb.glob('D:/OpenData/flowers/raw/tulip/*')
save_npy_image('D:/OpenData/flowers/npy/daisy_128.npy', daisy_image_list)
save_npy_image('D:/OpenData/flowers/npy/dandelion_128.npy', dandelion_image_list)
save_npy_image('D:/OpenData/flowers/npy/rose_128.npy', rose_image_list)
save_npy_image('D:/OpenData/flowers/npy/sunflower_128.npy', sunflower_image_list)
save_npy_image('D:/OpenData/flowers/npy/tulip_128.npy', tulip_image_list)
野菜と果物を読み込みnpy形式で保存。
fruit_vegetable_path_list = gb.glob('D:/OpenData/Fruit-and-Vegetable-Image-Recognition/train/*/*')
fruit_vegetable_image_list = load_images(fruit_vegetable_path_list, show=False)
save_npy_image('D:/OpenData/Fruit-and-Vegetable-Image-Recognition/npy/fruit_vegetable_128.npy', fruit_vegetable_image_list)
学習・予測
こちらは過去に書いたコードをほぼそのまま引っ張ってきてます。
noleff.hatenablog.com
まずは学習するためのデータを準備をします。
def load_npy_image(load_path):
return np.load(load_path, allow_pickle=True)
daisy = load_npy_image('D:/OpenData/flowers/npy/daisy_128.npy')
dandelion = load_npy_image('D:/OpenData/flowers/npy/dandelion_128.npy')
rose = load_npy_image('D:/OpenData/flowers/npy/rose_128.npy')
sunflower = load_npy_image('D:/OpenData/flowers/npy/sunflower_128.npy')
tulip = load_npy_image('D:/OpenData/flowers/npy/tulip_128.npy')
fruit_vegetable = load_npy_image('D:/OpenData/Fruit-and-Vegetable-Image-Recognition/npy/fruit_vegetable_128.npy')
flowers_labels = [re.split('[\\\.]',path)[-1] for path in gb.glob('D:/OpenData/flowers/raw/*')]
fruit_vegetable_labels = [re.split('[\\\.]',path)[-1] for path in gb.glob('D:/OpenData/Fruit-and-Vegetable-Image-Recognition/train/*')]
labels = flowers_labels + fruit_vegetable_labels
データセットを作ります。
def make_dataset(daisy, dandelion, rose, sunflower, tulip, fruit_vegetable, fruit_vegetable_labels):
flowers = np.concatenate([daisy, dandelion], axis=0)
flowers = np.concatenate([flowers, rose], axis=0)
flowers = np.concatenate([flowers, sunflower], axis=0)
flowers = np.concatenate([flowers, tulip], axis=0)
X = np.concatenate([flowers, fruit_vegetable], axis=0)
labels = [0] * len(daisy) + [1] * len(dandelion) + [2] * len(rose) + [3] * len(sunflower) + [4] * len(tulip)
for i in range(len(fruit_vegetable_labels)):
labels += [i+5] * 100
y = np.array(labels)
return X, y
X, y = make_dataset(daisy, dandelion, rose, sunflower, tulip, fruit_vegetable, fruit_vegetable_labels)
X_train, X_val, y_train, y_val = train_test_split(X, y, test_size=0.20, shuffle=True, random_state=2021)
学習です。keras使ってCNNぶん回します。
import tensorflow.keras as keras
from tensorflow.keras.models import Sequential, Model, load_model
from tensorflow.keras.layers import AveragePooling2D, Dense, Conv2D, MaxPooling2D, Flatten, Input, Activation, add, Add, Dropout, BatchNormalization
from tensorflow.keras.optimizers import SGD
from tensorflow.keras.callbacks import EarlyStopping
from tensorflow.keras.utils import to_categorical
from sklearn.model_selection import train_test_split
from sklearn.metrics import classification_report, confusion_matrix, accuracy_score, recall_score, precision_score, f1_score
from sklearn.model_selection import StratifiedKFold
from tensorflow.keras.applications import InceptionV3
from tensorflow.keras.preprocessing.image import ImageDataGenerator, load_img, save_img, img_to_array, array_to_img
def build_inception_model(out_shape):
base_model = InceptionV3(weights='imagenet',
include_top=False,
input_tensor=Input(shape=(128, 128, 3)))
x = base_model.output
x = AveragePooling2D(pool_size=(2, 2))(x)
x = Dropout(.4)(x)
x = Flatten()(x)
predictions = Dense(out_shape, activation='softmax')(x)
model = Model(base_model.input, predictions)
opt = SGD(lr=.01, momentum=.9)
model.compile(optimizer=opt, loss='categorical_crossentropy', metrics=['accuracy'])
model.summary()
return model
def build_base_model(out_shape):
'''
初期化 (initializer)
Glorotの初期化法:sigmoid関数やtanh関数
Heの初期化法:ReLU関数
https://ichi.pro/zukai-10-ko-no-cnn-a-kitekucha-164752979288397
'''
model = Sequential()
model.add(Conv2D(16, kernel_size=(5, 5), activation='relu', kernel_initializer='he_normal', input_shape=(128, 128, 3)))
model.add(MaxPooling2D(pool_size=(3, 3)))
model.add(Conv2D(64, kernel_size=(5, 5), activation='relu', kernel_initializer='he_normal'))
model.add(MaxPooling2D(pool_size=(3, 3)))
model.add(Conv2D(256, kernel_size=(3, 3), activation='relu', kernel_initializer='he_normal'))
model.add(MaxPooling2D(pool_size=(2, 2)))
model.add(Dropout(0.4))
model.add(Flatten())
model.add(Dense(2560, activation='relu',kernel_initializer='he_normal'))
model.add(Dropout(0.2))
model.add(Dense(640, activation='relu', kernel_initializer='he_normal'))
model.add(Dense(128, activation='relu', kernel_initializer='he_normal'))
model.add(Dropout(0.2))
model.add(Dense(out_shape, activation='softmax'))
model.compile(
loss='categorical_crossentropy',
optimizer='adam',
metrics=['accuracy']
)
model.summary()
return model
def make_datagen(rr=30, wsr=0.1, hsr=0.1, zr=0.2, val_spilit=0.2, hf=True, vf=True):
datagen = ImageDataGenerator(
featurewise_center = False,
samplewise_center = False,
featurewise_std_normalization = False,
samplewise_std_normalization = False,
zca_whitening = False,
rotation_range = rr,
width_shift_range = wsr,
height_shift_range = hsr,
zoom_range = zr,
horizontal_flip = hf,
vertical_flip = vf,
validation_split = val_spilit
)
return datagen
def learn_model(model, X_train, y_train, X_val=None, y_val=None):
tr_datagen = make_datagen()
va_datagen = ImageDataGenerator()
early_stopping = EarlyStopping(monitor='val_loss',
min_delta=1.0e-3,
patience=20,
verbose=1)
if X_val is None:
hist = model.fit_generator(tr_datagen.flow(X_train, y_train, batch_size=32),
verbose=2,
steps_per_epoch=X_train.shape[0] // 32,
epochs=100,
)
else:
hist = model.fit_generator(tr_datagen.flow(X_train, y_train, batch_size=32),
verbose=2,
steps_per_epoch=X_train.shape[0] // 32,
epochs=100,
validation_data=(X_val, y_val),
callbacks=[early_stopping]
)
return hist
def predict_model(model, X_test):
y_pred = model.predict(X_test, batch_size=128)
return y_pred
y_onehot_train = to_categorical(y_train)
y_onehot_val = to_categorical(y_val)
model_base = build_base_model(len(labels))
hist_base = learn_model(model_base, X_train, y_onehot_train, X_val, y_onehot_val)
model_inception = build_inception_model(len(labels))
hist_incepiton = learn_model(model_inception, X_train, y_onehot_train, X_val, y_onehot_val)
model_base.save('../model/base.h5')
model_inception.save('../model/inception.h5')
続いて予測します。
model_base = load_model('../model/base.h5')
model_inception = load_model('../model/inception.h5')
pred_base = predict_model(model_base, pokemon)
pred_inception = predict_model(model_inception, pokemon)
pred_base = np.argmax(pred_base, axis=1)
pred_inception = np.argmax(pred_inception, axis=1)
結果をデータフレーム形式でまとめ、CSVで保存します。
def extract_sinnoh(pokemon_path_list):
"""
387~493
ナエトル~アルセウス
"""
sinnoh_pokemon_list = []
for pokemon in pokemon_path_list:
number = int(re.sub(r'[f]', '', (pokemon.split('\\')[1].split('.')[0].split('-')[0])))
pokemon = re.sub(r'[f]', '', (pokemon.split('\\')[1].split('.')[0]))
if number >= 387 and number <= 493:
sinnoh_pokemon_list.append(pokemon)
return np.array(sinnoh_pokemon_list)
pokemon_path_list = gb.glob('D:/OpenData/pokemon_dataset/Pokemon-Images-Dataset/pokemon/*')
sinnoh_pokemon_list = extract_sinnoh(pokemon_path_list)
pokemon_df = pd.DataFrame()
pokemon_df['sinnoh_pokemon'] = sinnoh_pokemon_list
pokemon_df['pred_base'] = pred_base
pokemon_df['pred_inception'] = pred_inception
pokemon_df.to_csv('../data/result.csv', index=False)
予測精度
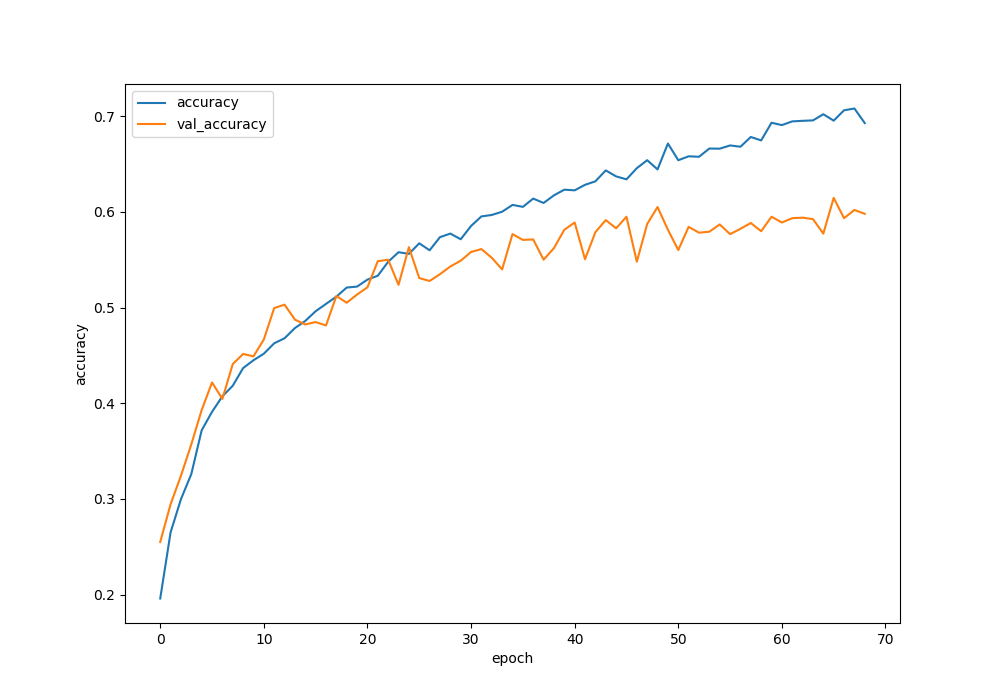
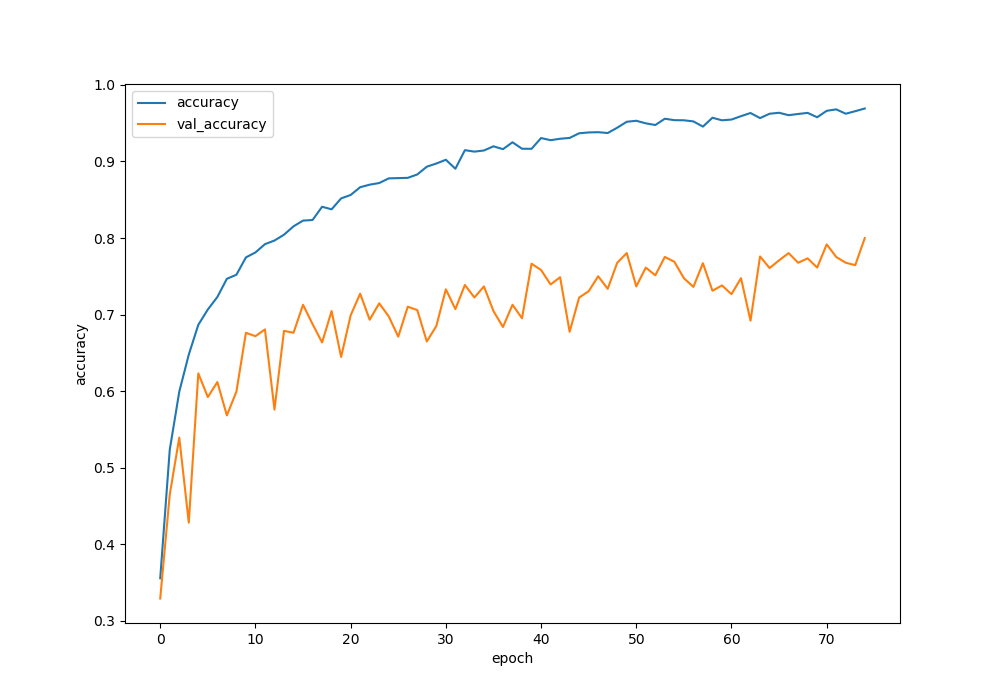
ポケモンが何に分類されたか抜粋
愛しのポッチャマがバナナという結果になりました。
どこがバナナだったんでしょうか。くちばしですかね。
ともあれ、先んじて【すだち】宣言して正解?です。
まとめ
青果にある商品の画像データをもとに分類器を作り、ポケモンの画像で予測させてみました。
結果はいかがだったでしょうか。
おそらく、全シンオウ地方ポケモンの内、ロズレイドしか納得できないですね、はい。
ネットワークサービスにおける任天堂の著作物の利用に関するガイドライン|任天堂
ご利用について|ポケットモンスターオフィシャルサイト